以前の記事で暗号化したHDDを東京から札幌の実家に数か月毎に持ち帰っていることを書きました。
この方法を数年続けており今のところ問題ありませんが、次のHDDの持ち帰りまでの数ヶ月間のブランクで災害が起きるとデータが失われる可能性があります。これとは別に毎日差分バックアップを取っていますが保存先が共に自宅内なので被災するとデータ消失のリスクがあります。
最近の自然災害の多さもあり、次のHDDの持ち帰りまでの間のデータをAmazon S3にバックアップする事にしました。
運用方針
物理HDD+AWSのハイブリッドで運用します。
- 暗号化したHDDを東京→札幌に持ち帰り
- 次回のHDDの持ち帰りまでの差分をS3にバックアップ
- (次回) 暗号化したHDDを東京→札幌に持ち帰り
- S3のオブジェクトを全削除
- 次回のHDDの持ち帰りまでの差分をS3にバックアップ
- …以下繰り返し
容量単価は物理HDDには適わないため、メインは従来通り物理HDDとし、S3はあくまで間の繋ぎとしての位置づけです。
なお、実家にSVを置いて拠点間バックアップも検討しましたが、電気代やトラブル時の遠隔メンテの困難もあり、物理HDD+クラウド方式が最良と判断しました。
構成の概要
以下の構成で作成します
- Amazon S3 Glacier Deep Archiveに保存。リージョンはus-east-1
- 既に運用中の差分バックアップスクリプトにS3アップロード処理を追加
- アップロードファイルはAES256で暗号化
- Multipart Uploadで100MBチャンクでS3にアップロード
- ファイルの更新日時をメタデータで保持
- バージョニングは行わない
バックアップのみで有事以外はダウンロードしないため安価なS3 Glacier Deep Archiveを用います。データ消失時の復旧速度は求めていないため、取り出し時は大容量取り出し(Bulk Retrieval)とする予定です。
また、災害目的のバックアップなため日本国外で自然災害が少なくコストの安い米国東部(us-east-1)を選択しています。イラン戦争でAWSの中東リージョンがデータ消失したニュース があるため戦争リスクを考えると米国リージョンも微妙かもしれません。地政学的にオーストラリアのリージョンが最も安全と考えてますがコストの関係で今回はus-east-1にしてます。本気でデータを守るなら地理的に離れたマルチリージョンが必須です。
S3はデフォルトで保存データが暗号化されますが、AWSのアクセスキー等の漏洩などを考慮してファイル自体をAES256で暗号化してからアップロードします。
コスト見積もり
次のHDD持ち帰りまでの増分データ数・ファイルサイズを見積もります。過去数年のファイルの増分を洗い出すと、6ヵ月平均で2000ファイル・50GBとなりました。
S3 Glacier Deep Archive・us-east-1の料金は以下です。
- 保管料:1ヶ月で$0.00099/GB
- 最低保存期間が180日間なので必ず最低6ヶ月分の料金が発生
- PUT料:$0.05/1000ファイル
- 取り出し料:大容量取り出しで$0.0025/GB
2000ファイル・50GBを6ヶ月間保存すると、
| 操作 | 料金 |
| 保管料(最低6か月) | 46円 |
| PUT料金 | 16円 |
| 取り出し料金 | 20円+α |
※1ドル=155円
基本的に取り出しは発生しないため実質60円でバックアップ可能です。仮にファイル数・サイズが倍としても120円です。
4000ファイル・100GB
| 操作 | 料金 |
| 保管料(最低6か月) | 92円 |
| PUT料金 | 32円 |
| 取り出し料金 | 40円+α |
厳密にはMultipart Uploadではファイル数ではなく各パートのアップロードリクエストで料金ががかかり、また更新日時を納めるメタデータ分のオーバヘッドもあるため若干高くなりますが、それでも非常に安いです。
あくまで次のHDDの持ち帰りまでの増分のみなのでこのコストで済んでいます。仮にフルバックアップすれば約4TBなので数千円になります。
S3バケットの作成
リージョンはus-east-1を選択
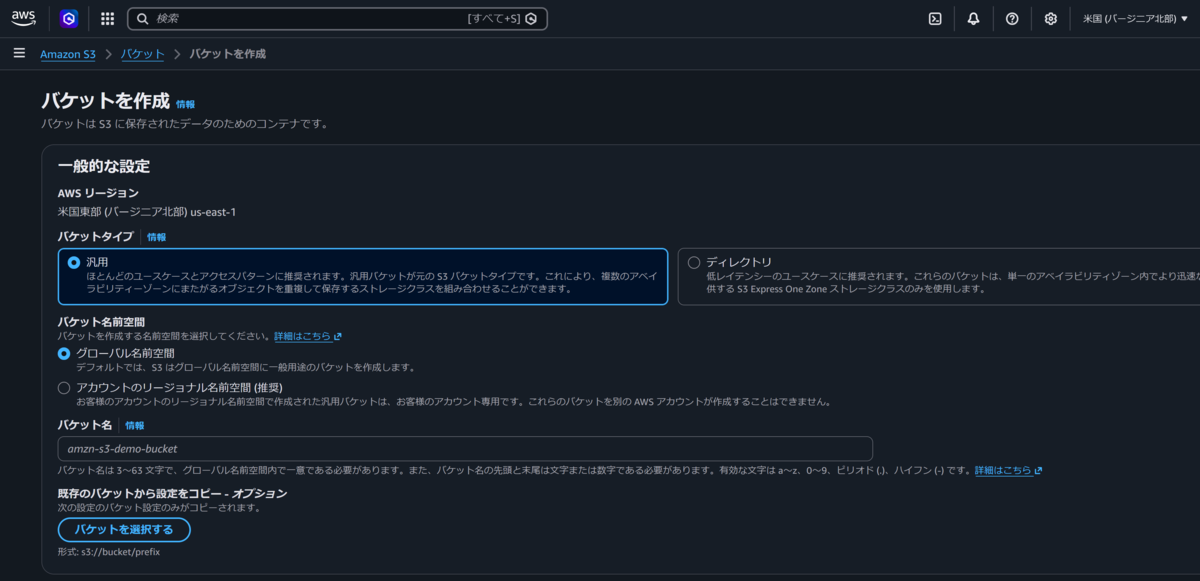
パブリックアクセスは全ブロックで、バージョニングは使いません。
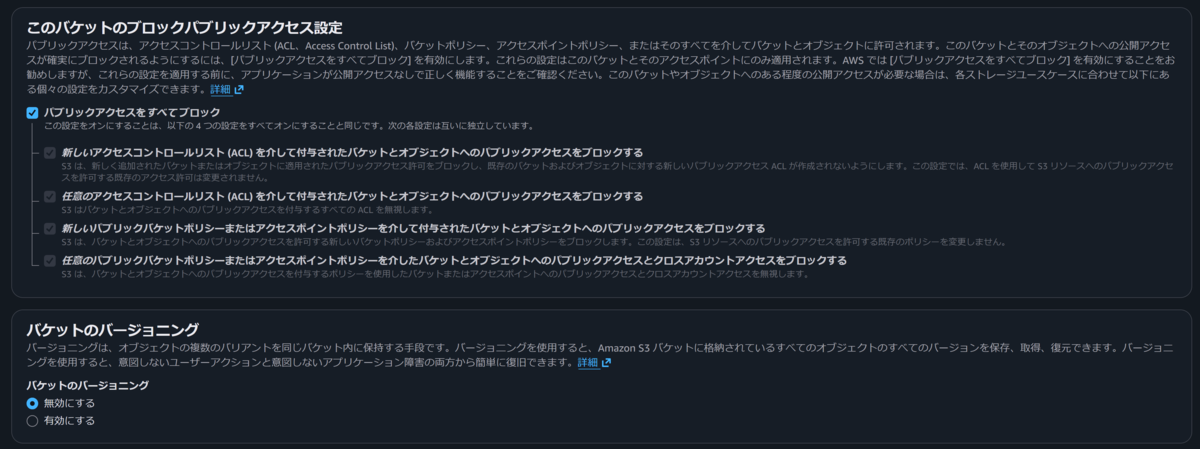
後の項目もデフォルトのままでバケットを作成します。
バックアップデータのアップロード用のIAMユーザーを作成し、バケットポリシーでPutObject権限のみ与えます。GetObject権限はバックアップの復元が必要な時に与えます。
{
    "Version": "2012-10-17",
    "Statement": [
        {
            "Sid": "Statement1",
            "Effect": "Allow",
            "Principal": {
                "AWS": "arn:aws:iam::XXXXXXXXXXXXXXXXXXXXXXXXXXXX"
            },
            "Action": "s3:PutObject",
            "Resource": "arn:aws:s3:::XXXXXXXXXXXXXXXXXXXXXXXXXXXXXX/*"
        }
    ]
}
アップロードするファイルの暗号化
AES-256・CBCでファイルを暗号化するクラスを作成します。エンコード処理ではファイルを100MiB毎のチャンクで暗号化してyieldを返し、呼び出し元でmultipart uploadします。巨大ファイルでもオンメモリで連続的に暗号化→アップロードが可能です。
デコードではS3からのダウンロードのStreamingBodyを受け取り、100MiB毎にデコードします。
from collections.abc import Iterator

from botocore.response import StreamingBody
from Crypto.Cipher import AES
from Crypto.Util import Padding

class Crypter:
    blocksize = 16

    def __init__(self) -> None:
        self.key = Padding.pad("xxxxxxxx", 32, "pkcs7")
        self.iv = b"xxxxxxxxxxxxxxxx"
        self.chunk_size = 1024 * 1024 * 100  # 100MiB

    def encode(self, srcpath: str) -> Iterator[bytes]:
        """ファイルを暗号化してchunkをyieldで返す

        Args:
            srcpath (str): ファイルパス

        Yields:
            Iterator[bytes]: 暗号化したchunk
        """
        aes = AES.new(self.key, AES.MODE_CBC, self.iv)
        with open(srcpath, mode="rb") as f:
            while chunk := f.read(self.chunk_size):
                chunk = Padding.pad(chunk, Crypter.blocksize, "pkcs7")
                yield aes.encrypt(chunk)

    def decode(self, body: StreamingBody, destpath: str) -> None:
        """s3.get_object()のstreaming bodyを復号化してファイルに書き込む

        Args:
            body (StreamingBody): s3.get_object()のstreaming body
            destpath (str): 復号ファイルのパス
        """
        aes = AES.new(self.key, AES.MODE_CBC, self.iv)
        with open(destpath, mode="wb") as fw:
            while chunk := body.read(self.chunk_size + Crypter.blocksize):
                print(len(chunk))
                decoded = aes.decrypt(chunk)
                decoded = Padding.unpad(decoded, Crypter.blocksize, "pkcs7")
                fw.write(decoded)
説明のために暗号keyやivはソース埋め込みですが、実際にはSSMのパラメータストアから取得しています。
暗号化したchunkをmultipartでS3にアップロード
先ほど暗号化したデータのchunkをマルチパートアップロードします。そのままではファイルの更新日時が保持されないためメタデータとして付与します。StorageClassの指定もここで行います。
def upload_file(filepath: str):
    client = boto3.client("s3", region_name="us-east-1")
    crypter = Crypter()
    mtime = os.stat(filepath).st_mtime
    try:
        create_response = client.create_multipart_upload(
            Bucket="bucket_name",
            Key="XXXX",
            Metadata={"mtime": str(mtime)},  # 更新日時をメタデータに入れる
            StorageClass="DEEP_ARCHIVE"
        )
        parts = []
        # チャンク区切りで暗号化してmultipart upload
        for i, encoded_chunk in enumerate(crypter.encode(filepath), start=1):
            response = client.upload_part(
                Bucket="bucket_name",
                Key="XXXX",
                UploadId=create_response["UploadId"],
                PartNumber=i,
                Body=encoded_chunk,
            )
            parts.append({"ETag": response["ETag"], "PartNumber": i})

        client.complete_multipart_upload(
            Bucket="bucket_name",
            Key="XXXX",
            UploadId=create_response["UploadId"],
            MultipartUpload={"Parts": parts},
        )

    except Exception as e:
        # 失敗時はabort
        response = client.abort_multipart_upload(
            Bucket="bucket_name",
            Key="XXXX",
            UploadId=create_response["UploadId"],
        )
S3からの復元処理
復元処理ではget_object()で返されるStreamingBodyを受け取り、100MiB毎に復号化します。ファイル生成後に元の更新日時を再セットします。
def download_file(filepath: str):
    response = client.get_object(
        Bucket="bucket_name",
        Key="XXXX",
    )

    crypter = Crypter()
    crypter.decode(response["Body"], filepath)
    mtime = float(response["Metadata"]["mtime"])
    os.utime(filepath, (mtime, mtime))  # 更新日時を再セット
バックアップ対象の検知
バックアップ元・先のローカルディスクをチェックし、バックアップ先に無い新規ファイルやファイルの更新日時・サイズが異なるファイルをコピーします。バージョニングはせず、削除同期も行いません。
コピー対象のファイルは先にS3のアップロード処理に流します。アップロードが成功したらローカルディスク間のコピーを行い、失敗したらローカルディスクのコピーを行いません。これにより次回のバックアップ時に再度アップロード対象として検知されます。
ソースは割愛します。
運用してみて
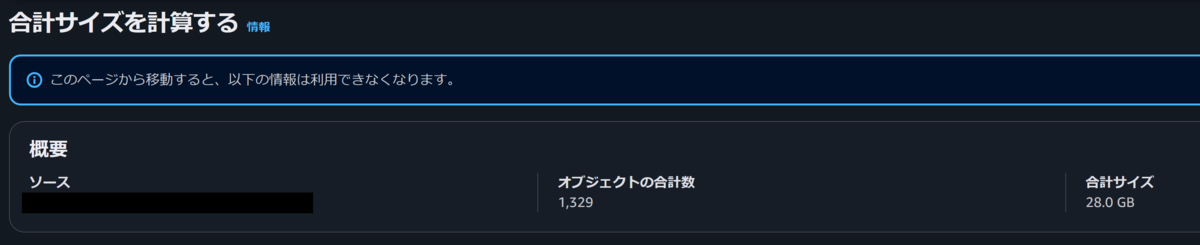
運用開始から7日が経ち、1300ファイル・28GBがアップロードされました。
コストですが、初回のアップロードで大量の同期が走りますが、それ以降の毎日の増分は少なくほぼ0ドルです。S3よりKMSの方がコストが掛かっていますね。。
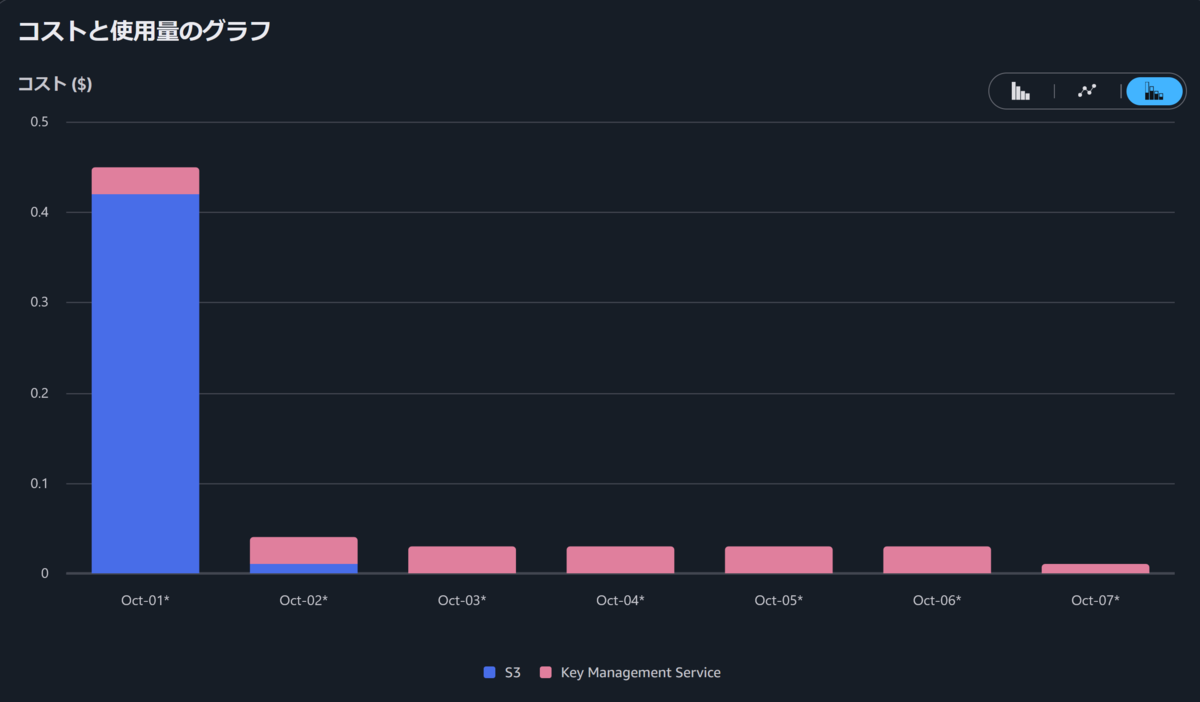
本質のストレージよりコストが掛かるのは解せないので、クライアント側暗号のキー管理でKMSを使わない方法も検討したいです。
さて、東京+札幌/アメリカという実質的なマルチリージョンでバックアップする事ができました。あとは復元が必要な時に無事に復旧できるかが肝ですが、そのような事態が起きないことを祈るのみです。(そもそも私が災害等で死んでしまうとデータ復元も元も子もないので…)